ハフモデルとは「店が選ばれる確率」を推計するモデル
ハフモデルとは、ある地域に住む消費者が、複数の店のうちどの店をどれくらいの確率で選ぶかを推計するモデルです。1960年代に米国の研究者デビッド・ハフが提唱し、小売業の商圏分析で広く知られるようになりました。
考え方はシンプルです。消費者は「魅力の大きい店」と「近い店」を選びやすい、というものです。魅力が大きくても遠すぎれば行かず、近くても魅力が小さければ選ばれにくい。このバランスを数式で表したのがハフモデルです。
ハフモデルの特徴は、競合店を計算に組み込める点です。人口だけを見る方法では、近くに大型の競合店ができても数字は変わりません。ハフモデルなら、競合店の魅力と距離を入れることで、自店が取れる客の割合がどれだけ減るかを見積もれます。この点が、半径や到達圏で人口を数える方法との大きな違いです。
ハフモデルの計算式と意味
ハフモデルでは、まず店ごとに「魅力度 ÷ 距離のλ乗」を計算します。次に、その値を地域内のすべての店で合計し、各店の値を合計で割ります。これが、その地域の消費者がその店を選ぶ確率です。
λ(ラムダ)は「距離抵抗係数」と呼ばれるパラメータです。λが大きいほど、距離が少し伸びただけで選ばれにくくなります。日用品のように近くで済ませたい商品ほどλは大きく、遠くても比べて買いたい商品ほど小さくなると考えられます。経験則として2前後が使われることが多いものの、本来は業種や地域の実データから推定する値です。
- 店jを選ぶ確率 =(店jの魅力度 ÷ 店jまでの距離のλ乗)÷ 地域内の全店舗について同じ値を合計したもの
- 魅力度:売場面積を使うのが一般的。品ぞろえや駐車台数を加える応用もある
- 距離:直線距離のほか、移動時間を使うこともある
- λ(距離抵抗係数):距離が選択に与える影響の強さ。目安として2前後
日本では、λを2に固定した「修正ハフモデル」が、かつて大型店の出店調整の場面で用いられたことでも知られています。
簡単な計算例
仕組みを理解するために、説明用の仮の数値で計算してみます。ある住宅地から見て、店Aは売場面積1,000㎡で距離1km、店Bは売場面積2,000㎡で距離2kmにあるとします。λは2とします。
店Aの値は 1,000 ÷ 1² = 1,000、店Bの値は 2,000 ÷ 2² = 500 です。合計は1,500なので、店Aが選ばれる確率は約67%、店Bは約33%になります。店Bは面積が2倍でも、距離が2倍なので「2の2乗=4倍」の抵抗を受け、店Aに負けるわけです。仮にλを1にすると、店Aと店Bの値はどちらも1,000になり、確率は50%ずつに変わります。λの置き方ひとつで結論が逆転しうることが分かります。
| 店 | 売場面積 | 距離 | 面積 ÷ 距離² | 選ばれる確率 |
|---|---|---|---|---|
| 店A | 1,000㎡ | 1km | 1,000 | 約67% |
| 店B | 2,000㎡ | 2km | 500 | 約33% |
| 合計 | — | — | 1,500 | 100% |
実際の分析では、地域を町丁やメッシュに細かく分け、それぞれで確率を計算し、各地域の人口や世帯数を掛けて足し合わせます。
出店判断での使い方と限界
ハフモデルは、競合店がある中で自店がどれだけ客を取れるかを考えるのに役立ちます。新しい店を出したときに、既存店の客がどれくらい移るかを見積もる使い方もあります。商圏から売上を予測する方法の一つの手法として位置づけられます。
一方で、限界もはっきりしています。魅力度を売場面積だけで表すため、価格・味・接客・ブランドなどの差は反映されません。面積で比べにくいサービス業や、立ち寄り型の店には合いにくいのが実情です。また、λの値で結果が大きく変わるため、根拠のない値を置くと数字だけがひとり歩きします。
- 向いている:スーパー、ホームセンター、ショッピングセンターなど面積で比べやすい業態
- 向いていない:カフェ、美容室、クリニックなど面積と魅力が比例しにくい業態
- 注意点:λの根拠、競合店の漏れ、通勤途中の「ついで買い」が反映されないこと
ハフモデルの前に、商圏の実データを確かめる
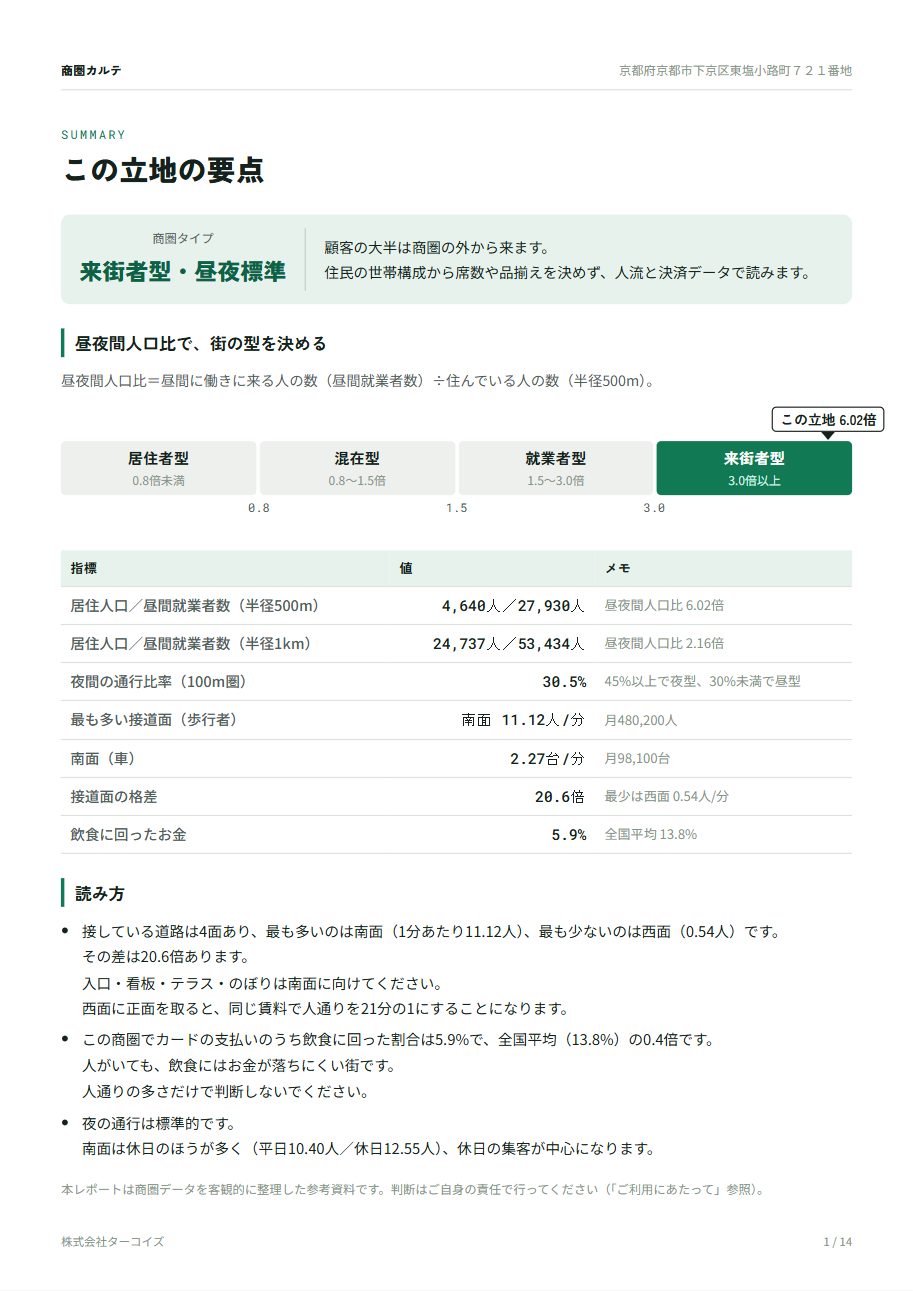
ハフモデルはあくまで推計の道具で、入力する人口や競合のデータが正確でなければ意味がありません。まずは候補地の商圏人口や客層、競合の状況を実データで確かめることが先決です。
商圏カルテは、住所を入れるだけで、居住人口・到達圏人口・通行量・決済データから見た客層をPDFにまとめ、24時間以内にお届けします。はじめての1回は無料です。商圏カルテからお試しください。